Open Loyalty brauchte einen Inbound-Vertriebsagenten, der mehr kann als chatten. Er sollte echte Nachfrage qualifizieren, Produktfragen auf Basis aktueller Materialien beantworten und dem Vertriebsteam einen strukturierten Datensatz hinterlassen. Soba Labs hat ihn gebaut und ausgeliefert.
Das Risiko im Produktivbetrieb lag in den Übergaben. Eine falsche Preisaussage konnte Vertrauen kosten. Eine schwache Qualifizierung konnte den falschen Lead auf den falschen Weg schicken. Eine wiederholte CRM-Aktion konnte aus einem Gespräch zwei Updates erzeugen.
Das Problem
Der Agent musste:
- auf Basis der aktuellen Produktpositionierung von Open Loyalty antworten statt auf Basis veralteter Dokumente;
- erkennen, ob der Besucher eine Marke, ein Händler, ein Partner oder eine Agentur war;
- die minimal nötigen Informationen für den Vertrieb erfassen, ohne das Gespräch in ein Formular zu verwandeln;
- den Besucher zu Self-Service, einem Termin oder einem Support-Weg leiten;
- Lead-Notizen, Tags und eine Übergabezusammenfassung in nachgelagerte Systeme schreiben.
Zwei Probleme zeigten sich, als das System auf echten Traffic traf.
Qualitätsdrift. Prompts, die im Staging zuverlässig wirkten, versagten bei unstrukturierten, mehrteiligen Fragen.
Versteckte Tool-Fehler. Probleme bei Retrieval-Augmented Generation und im CRM sahen oft wie eine seltsame Modellantwort aus, bis wir die Abfolge von Modellaufrufen, Tool-Aufrufen, Wiederholungsversuchen und Seiteneffekten untersuchen konnten.
Ein sporadischer Bug machte das zweite Problem greifbar. Ein kleiner Anteil der Gespräche erzeugte zwei CRM-Updates statt einem. Manuelle Tests fanden ihn selten, aber die doppelten Datensätze verursachten operativen Mehraufwand.
Das System
Wir haben den KI-Agenten als LangGraph-Zustandsmaschine modelliert. Der Gesprächszustand durchlief explizite Phasen für Begrüßung, Qualifizierung, Abruf, Vertriebsbriefing und CRM-Schreibvorgang.
class SDRState(MessagesState):
    lead_id: str
    lead: dict
    score: int
    next_action: str
    kb_context: list[Document]
    thread_id: str

graph = StateGraph(SDRState)
graph.add_edge("intro", "qualify")
graph.add_conditional_edges("qualify", needs_product_qa)
graph.add_edge("retrieve_kb", "sales_brief")
graph.add_edge("sales_brief", "crm_write")
graph.add_edge("crm_write", END)
Diese Struktur war wichtig, weil man bei einem Agenten im Produktivbetrieb eine Abfolge debuggen muss, nicht eine einzelne Antwort. Der Zustand zeigte, was der Besucher gefragt hatte, was der Abruf zurückgab, welcher Prompt lief, was das Modell entschied und welches Tool einen Seiteneffekt auslöste.
Was ihn zuverlässig machte
Jeden produktiven Gesprächsschritt tracen
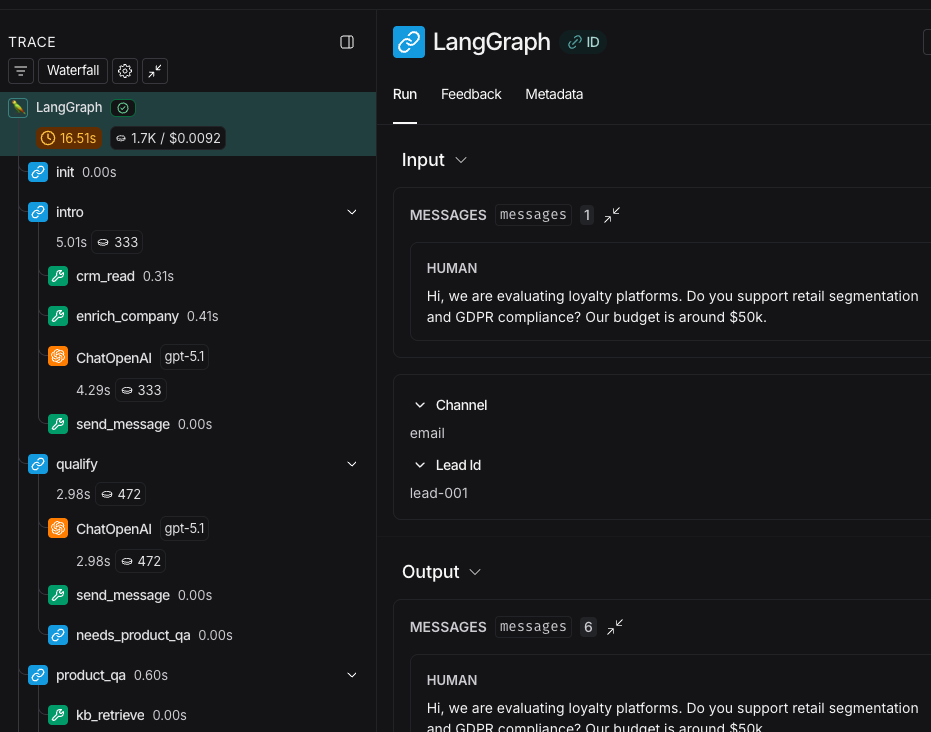
LangSmith gab dem Team einen durchgängigen Datensatz für jedes Gespräch. Sein Observability-Modell fasst alle Schritte einer Operation in einem Trace zusammen. Unser Trace umfasste Modellaufrufe, Tool-Aufrufe, Eingaben, Ausgaben, Latenz, Prompt-Version und Run-Metadaten.
Dadurch wurden Fehler reproduzierbar. Anhand einer Run-ID ließ sich beantworten, welcher Prompt das Verhalten erzeugt hatte, welchen Produktkontext der Abruf zurückgab und ob ein Tool-Aufruf neu oder ein Wiederholungsversuch war.
Qualität in einen Regressionstest verwandeln
Wir haben aus repräsentativen Gesprächen ein kleines Evaluationsset für KI-Agenten aufgebaut. Es deckte Preisfragen, Einwände, unklare Absichten, fehlende Felder und mehrteilige Anfragen ab.
Jede relevante Änderung an Prompt, Modell, Abrufeinstellungen oder Tool-Schema konnte gegen dasselbe Set laufen. Produkt und Vertrieb konnten prüfen, ob sich Routing, Quellenbindung und Feldextraktion über das gesamte Set verbesserten, statt über ein einzelnes Transkript zu diskutieren.
Die ersten Prüfungen blieben bewusst konkret:
- Hat der Agent den Lead richtig geroutet?
- Hat er die erforderlichen Felder extrahiert?
- Ist er bei freigegebenem Produktmaterial geblieben?
- Hat er einen unsicheren oder doppelten Seiteneffekt vermieden?
Produktivfehler in das Engineering zurückführen
Strukturiertes Feedback machte aus echten Runs eine priorisierte Reparatur-Warteschlange. Statt nur ein Daumen-hoch- oder Daumen-runter-Signal zu sammeln, klassifizierte das Team Fehler wie falsches Routing, nicht belegte Aussagen, fehlende Felder, unpassenden Ton und Tool-Fehler.
Die besten Beispiele wanderten anschließend in das Evaluationsset. Ein Produktivproblem wurde zum Testfall für das nächste Release.
Der Bug mit der doppelten Aktion
Das doppelte CRM-Update tauchte nicht in der finalen Antwort des Assistenten auf. Der Schaden entstand im Seiteneffekt.
Der Trace zeigte die genaue Abfolge. Ein CRM-Schreibvorgang lief in einen Timeout. Der Agent versuchte es erneut. Der zweite Aufruf war erfolgreich, während der erste kurz darauf ebenfalls abgeschlossen wurde. Ein Gespräch hatte zwei Schreibvorgänge erzeugt.
Wir haben die CRM-Grenze auf drei Arten abgesichert:
- Jeder Schreibvorgang erhielt einen Idempotenzschlüssel, abgeleitet aus Gespräch und Gesprächsschritt.
- Modell-Wiederholungen und Tool-Wiederholungen wurden zu getrennten Entscheidungen.
- Das Evaluationsset erhielt einen simulierten Timeout-Fall, der ein Lead-Update pro Gesprächsschritt sicherstellte.
crm_write.invoke({
    "lead_id": state["lead_id"],
    "payload": payload,
    "idempotency_key": f"{thread_id}:{turn_id}",
})
Deshalb war LLM-Observability mehr als eine Debugging-Hilfe. Sie zeigte, welche Systemgrenze eine stärkere Garantie brauchte.
Das Ergebnis
Open Loyalty erhielt einen Vertriebsagenten, der eingehende Nachfrage qualifizieren, auf Basis einer nachvollziehbaren Produktwissensbasis antworten und strukturierte Ergebnisse an das Vertriebsteam übergeben kann. Die begleitenden Kontrollen machten jeden produktiven Gesprächsschritt überprüfbar und jede relevante Änderung testbar.
Die praktische Lehre ist einfach. Wenn ein Agent Revenue Operations berührt, trennen Sie Denken und Handeln. Tracen Sie beides, machen Sie Seiteneffekte idempotent und pflegen Sie ein kleines Evaluationsset aus echten Gesprächen.
In den Worten des Kunden
“Soba Labs put an AI sales agent into production for us. It qualifies inbound leads, answers only from our current product material, and leaves the sales team a structured record of every conversation.”
Karol Bzik, CPO, Open Loyalty
Technische Quellen
Zuletzt aktualisiert: